Зміст
Усе, що чекає на вас у книзі «Split Python: розбиття рядків на практиці»:
Розділ 1. Перший рядок, який розкладається на слова
Почніть із практичного результату: розділіть звичайний текст на слова методом str.split(), отримайте список і навчіться використовувати його далі в програмі. На простих прикладах розберіть синтаксис, значення sep і maxsplit та відмінність між викликом split() і роботою з отриманим списком.
Розділ 2. Коли програма читає введення користувача
Навчіться перетворювати рядок, отриманий через input(), на окремі значення для подальших обчислень. Розгляньте input().split(), розпакування результату, перетворення рядків на числа та обробку ситуацій, коли користувач вводить зайві або пропущені значення.
Розділ 3. Роздільник має значення
З'ясуйте, як split() поводиться з комами, крапками з комою, двокрапками, вертикальними рисками та іншими символами. Порівняйте розбиття за конкретним sep із типовим розпізнаванням пробільних символів і навчіться правильно обробляти порожні фрагменти.
Розділ 4. Пробіли, табуляція та переноси рядків
Розберіть, як Python розділяє текст за пробілами, табуляцією та символами нового рядка. На прикладах багаторядкових записів опануйте обробку текстових файлів, метод splitlines() і відмінності між ним та split('\n').
Розділ 5. Коли потрібно починати з кінця
Освойте rsplit() і навчіться контролювати напрямок розбиття за допомогою maxsplit. Розгляньте практичні сценарії: відокремлення розширення файла, виділення останньої частини шляху та розбір записів із непередбачуваною кількістю роздільників.
Розділ 6. Рядок перетворюється на структуру даних
Навчіться перетворювати результати розбиття на вкладені списки, групувати елементи та розділяти колекції на підсписки. Порівняйте обробку рядків і списків, розгляньте розбиття за значенням та типові помилки під час роботи з індексами й типами даних.
Розділ 7. Коли одного роздільника вже замало
Перейдіть від звичайного split() до регулярних виразів із модулем re. Навчіться застосовувати re.split() для кількох роздільників, груп символів і складніших текстових шаблонів, а також розберіть особливості збереження роздільників у результаті.
Розділ 8. Зворотна коса риска та мова шаблонів
Розберіть значення зворотної косої риски в Python і регулярних виразах: екранування символів, спеціальні послідовності та сирі рядки з префіксом r. На практичних прикладах навчіться записувати шаблони для пробілів, цифр, меж слів і спеціальних символів без плутанини між синтаксисом Python та re.
Розділ 9. Знайти й замінити саме те, що потрібно
Опануйте пошук збігів, заміну фрагментів і витягування потрібних груп із тексту за допомогою re.search(), re.findall(), re.finditer() та re.sub(). Розберіть сценарії очищення журналів подій, вилучення ідентифікаторів та нормалізації текстових записів.
Розділ 10. Перевірка тексту на відповідність очікуванням
Навчіться створювати шаблони для перевірки структури текстових значень і відокремлювати пошук збігу від перевірки всього рядка. Розгляньте re.fullmatch(), групи, квантифікатори, альтернативи та межі застосування регулярних виразів у валідації вхідних даних.
Розділ 11. Текстовий конвеєр у реальній програмі
Об'єднайте розбиття, очищення, пошук, заміну та перевірку в послідовний конвеєр обробки тексту. На прикладах журналів подій, CSV-подібних записів і напівструктурованих даних розберіть помилки, обробку винятків, тестування граничних випадків і безпечну роботу з некоректним введенням.
Розділ 12. Від окремого шаблону до надійної системи
Перейдіть до проєктування повторно використовуваних інструментів текстової обробки: компіляції регулярних виразів, оцінювання продуктивності, тестування та документування шаблонів. Розгляньте інтеграцію з автоматизованими процесами, потоками даних і системами аналізу тексту, зокрема під час підготовки даних для моделей ШІ.
Про цю книгу
Рядок у Python може містити десятки слів, зайві пробіли, кілька роздільників і непередбачуване введення користувача — але програмі часто потрібен лише один конкретний фрагмент. Ви викликаєте `split`, отримуєте список, а потім виявляєте, що дані розділилися не так, як очікували. Або використовуєте регулярний вираз там, де вистачило б одного вбудованого методу.
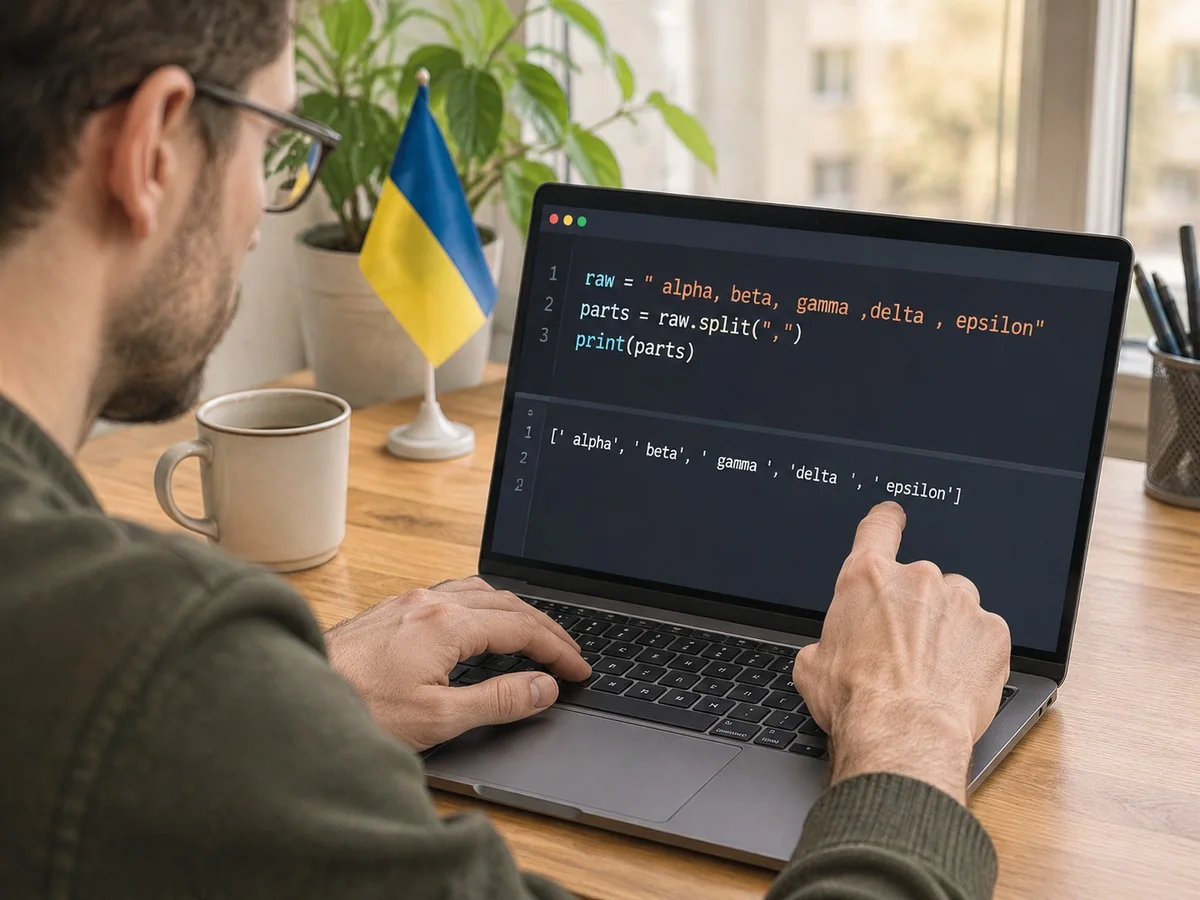
Робота з текстом починається не зі складних регулярних виразів, а з правильного вибору роздільника. Наприклад, `split` без аргументів обробляє послідовності пробільних символів як один роздільник і не створює порожніх елементів через зайві пробіли на початку чи в кінці. Натомість `split(' ')` шукає саме звичайний пробіл і може повернути порожні фрагменти. Ця невелика відмінність здатна зіпсувати подальшу обробку даних.
Антон Пилипенко показує, як перетворити розрізнені текстові операції на зрозумілий алгоритм. Ви навчитеся розбирати користувацьке введення, працювати з файлами й журналами подій, знаходити підрядки, перевіряти формати та створювати послідовні конвеєри обробки. Замість набору випадкових прийомів у вас буде система вибору інструментів: від `str.split` до `re.split`, `re.search` і `re.sub`. Кожне рішення матиме зрозумілу причину, а результат можна буде перевірити.
Метод СЛОТ: чотири кроки від сирого рядка до надійного результату
Метод СЛОТ допомагає розв'язувати текстові завдання послідовно: спочатку з'ясувати структуру даних, потім знайти потрібні межі, виконати операцію й перевірити результат. Він однаково доречний для короткого рядка з клавіатури та великого набору текстових записів.
- С — Сформулювати структуру вхідного тексту й визначити очікуваний результат розбиття. З'ясуйте, що містить рядок, які фрагменти потрібні програмі та в якому вигляді вони мають бути представлені. Наприклад, якщо введення містить ім'я та вік, результатом має стати список із двох елементів, а не випадкова колекція слів.
- Л — Локалізувати роздільники, межі та потрібні фрагменти рядка. Визначте, що саме розмежовує дані: пробіл, кома, двокрапка, перенос рядка чи складніший повторюваний шаблон. Перевірте, чи можуть роздільники повторюватися та чи мають значення порожні фрагменти.
- О — Обробити текст за допомогою split, rsplit, partition і регулярних виразів. Виберіть найпростіший інструмент, який відповідає структурі завдання. Виконайте розбиття, пошук, заміну або витягування потрібних частин і перетворіть результат на відповідну структуру даних.
- Т — Тестувати результат на граничних випадках, перевіряти дані та вдосконалювати рішення. Перевірте порожні рядки, зайві роздільники, некоректне введення й незвичні символи. Переконайтеся, що програма не завершується помилкою через несподівану кількість елементів або невдале перетворення типу.
Від першого split до текстових конвеєрів: 12 сходинок майстерності Python
Кожен розділ розв'язує окреме практичне завдання. Послідовність побудована так, щоб ви не переходили до складних шаблонів, поки не навчитеся впевнено користуватися простими інструментами.
Розділ 1. Перший рядок, який розкладається на слова — Ви почнете з `str.split`, навчитеся отримувати список із текстового рядка та використовувати його елементи в програмі. Розберете параметри `sep` і `maxsplit`, а також побачите, чому результатом розбиття є список, тоді як початковий рядок залишається незмінним.
Розділ 2. Коли програма читає введення користувача — На практиці опрацюєте `input.split`, розпакування значень і перетворення рядків на числа. Окрему увагу приділено перевірці кількості введених елементів і перехопленню `ValueError`, щоб помилка користувача не перетворювалася на аварію програми.
Розділ 3. Роздільник має значення — Коми, крапки з комою, двокрапки та вертикальні риски стануть зрозумілими інструментами розбиття. Ви навчитеся вибирати конкретний `sep`, порівнювати його з типовою обробкою пробілів і правильно трактувати порожні фрагменти.
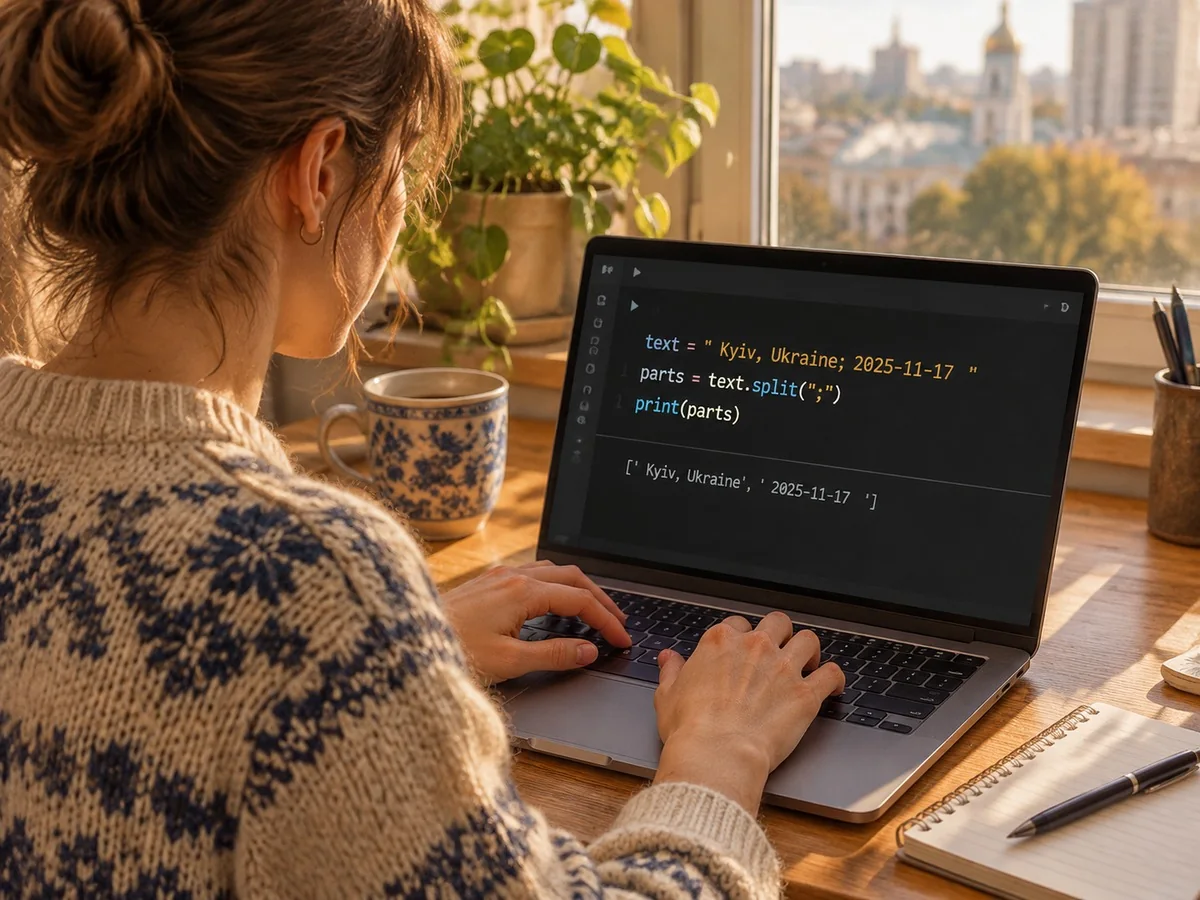
Розділ 4. Пробіли, табуляція та переноси рядків — Розберете обробку багаторядкового тексту, табуляції та пробільних символів у записах із файлів. Порівняння `splitlines`, `split('\n')` і `split` без аргументів допоможе уникнути помилок під час читання текстових даних.
Розділ 5. Коли потрібно починати з кінця — `rsplit` навчить вас розділяти рядок справа наліво та контролювати кількість розбиттів через `maxsplit`. На прикладах назв файлів, шляхів і текстових записів з'ясуєте, коли краще використовувати `split`, `rsplit` або `partition`.
Розділ 6. Рядок перетворюється на структуру даних — Результати розбиття перетворяться на вкладені списки та згруповані колекції. Ви розберете роботу з індексами, типами даних і відмінності між операціями над рядками та списками.
Розділ 7. Коли одного роздільника вже замало — Перейдете до модуля `re` і навчитеся використовувати `re.split` для кількох роздільників та складніших шаблонів. Групи захоплення допоможуть зрозуміти, як зберігати роздільники в результаті, коли це потрібно для подальшої обробки.
Розділ 8. Зворотна коса риска та мова шаблонів — Розберете, що означає `\` у рядках Python і регулярних виразах, навіщо потрібен префікс `r` та як працюють `\d`, `\w` і `\s`. Навчитеся записувати шаблони для цифр, пробілів, меж слів і спеціальних символів без плутанини між двома рівнями екранування.
Розділ 9. Знайти й замінити саме те, що потрібно — За допомогою `re.search`, `re.findall`, `re.finditer` і `re.sub` навчитеся знаходити збіги, витягувати групи та замінювати потрібні фрагменти. Практичні сценарії охоплюють очищення журналів подій, вилучення ідентифікаторів і нормалізацію записів.
Розділ 10. Перевірка тексту на відповідність очікуванням — Ви побудуєте шаблони з групами, альтернативами й квантифікаторами та навчитеся застосовувати `re.fullmatch` для перевірки всього рядка. Окремо розглянете межі регулярної валідації: шаблон може перевірити задану структуру, але не завжди здатен підтвердити справжність складного значення.
Розділ 11. Текстовий конвеєр у реальній програмі — Окремі операції об'єднаються в послідовний процес очищення, розбиття, пошуку, заміни й перевірки. Ви зможете обробляти некоректні записи, перехоплювати винятки, тестувати граничні випадки та працювати з журналами подій і напівструктурованими даними.
Розділ 12. Від окремого шаблону до надійної системи — Завершальний етап присвячено повторно використовуваним інструментам текстової обробки. Ви розберете компіляцію регулярних виразів, оцінювання продуктивності, документування шаблонів і створення конвеєрів для автоматизації, потоків даних та підготовки тексту для моделей ШІ.
Перші три хвилини: розберіть рядок і перевірте, що отримала програма
Почніть із невеликого експерименту в Python. Вам знадобиться лише середовище, у якому можна виконувати код: інтерактивна оболонка, редактор із запуском Python або звичайний файл із розширенням `.py`.
За кілька хвилин ви отримаєте список слів, побачите різницю між двома способами розбиття, перевірите напрямок роботи `rsplit` і спробуєте регулярний вираз. Головне — не просто виконати команди, а подивитися, що саме повертає кожен метод.
Крок 1. Розділіть перший рядок.
Відкрийте Python і введіть:
```python
text = "Python допомагає працювати з текстом"
words = text.split
print(words)
print(type(words))
print(text)
```
Перший рядок створює змінну `text` зі звичайним рядком. Другий викликає метод `split` без аргументів. Python розділяє текст за послідовностями пробільних символів і повертає список.
У результаті ви побачите:
```python
['Python', 'допомагає', 'працювати', 'з', 'текстом']
Python допомагає працювати з текстом
```
Перевірте три речі: отримано список, його тип — `list`, а початковий рядок не змінився. Це важливо, оскільки `split` повертає новий об'єкт, а не редагує вихідний текст.
Тепер дістаньте окремі слова:
```python
print(words[0])
print(words[-1])
print(len(words))
```
Індекс `0` повертає перший елемент, індекс `-1` — останній, а `len` визначає кількість елементів. Ви вже можете використовувати розбитий рядок у подальшій логіці програми.
Крок 2. Порівняйте два способи розбиття.
Створіть рядок із кількома пробілами між словами:
```python
text = "Python обробляє рядки"
print(text.split)
print(text.split(' '))
```
Перший виклик сприймає послідовність пробільних символів як один роздільник. Другий шукає кожен окремий звичайний пробіл. Тому в другому результаті з'являться порожні рядки між словами.
Порівняйте результати:
```python
['Python', 'обробляє', 'рядки']
['Python', '', '', 'обробляє', '', '', '', 'рядки']
```
Порожні елементи — не випадкова помилка Python. Це наслідок того, що між словами є кілька конкретних роздільників, а метод з явним `sep` зберігає інформацію про порожні фрагменти.
Для звичайного очищення тексту від зайвих пробілів використовуйте `split` без аргументів. Якщо ж точне розташування роздільників має значення, застосовуйте явний `sep`.
Крок 3. Змініть напрямок розбиття.
Тепер перевірте, як працює `maxsplit`:
```python
text = "схід-захід-північ-південь"
print(text.split('-', 1))
print(text.rsplit('-', 1))
```
Перший виклик виконує не більше одного розбиття зліва направо. Другий — не більше одного розбиття справа наліво.
Результати будуть такими:
```python
['схід', 'захід-північ-південь']
['схід-захід-північ', 'південь']
```
Зверніть увагу: `maxsplit=1` не означає, що Python залишить лише один фрагмент. Він обмежує кількість розбиттів, тому результат містить дві частини.
Цей прийом зручний, коли потрібен останній компонент запису, а початкова частина має залишитися нерозділеною. Наприклад, так можна відокремити кінцеву частину шляху або останній фрагмент текстового запису.
Крок 4. Перевірте partition.
Іноді вам не потрібен список усіх частин. Достатньо розділити рядок один раз і отримати три складники: текст перед роздільником, сам роздільник і текст після нього.
```python
record = "status:ready"
result = record.partition(":")
print(result)
print(type(result))
```
Результат:
```python
('status', ':', 'ready')
```
Метод `partition` завжди повертає кортеж із трьох елементів. Якщо роздільник не знайдено, першим елементом буде весь початковий рядок, а два наступні будуть порожніми рядками.
Перевірте це окремо:
```python
print("status".partition(":"))
```
Отримаєте:
```python
('status', '', '')
```
Це передбачувана поведінка, яку зручно використовувати під час обробки записів із фіксованим роздільником.
Крок 5. Спробуйте розділити текст кількома символами.
Звичайний `split` приймає один конкретний роздільник. Якщо потрібно розділяти текст і за комами, і за крапками з комою, скористайтеся `re.split`:
```python
import re
text = "Python,Java;JavaScript,Rust"
parts = re.split(r'[,;]', text)
print(parts)
```
Результат:
```python
['Python', 'Java', 'JavaScript', 'Rust']
```
Шаблон `[,;]` означає, що роздільником може бути кома або крапка з комою. Квадратні дужки задають групу символів, із яких достатньо знайти один.
Зверніть увагу на префікс `r` перед рядком шаблону. Він створює сирий рядок Python і спрощує запис регулярних виразів зі зворотною косою рискою.
Крок 6. Перевірте користувацьке введення.
Останній експеримент об'єднує розбиття та перевірку даних. Створіть програму:
```python
values = input("Введіть ім'я та вік: ").split
if len(values) != 2:
print("Потрібно ввести рівно два значення.")
else:
name, age_text = values
try:
age = int(age_text)
print(f"Ім'я: {name}")
print(f"Вік: {age}")
except ValueError:
print("Вік потрібно ввести цілим числом.")
```
Запустіть програму й перевірте три варіанти введення:
```text
Олена 25
Олена
Олена двадцять
```
У першому випадку програма отримає два елементи, успішно перетворить другий на ціле число й виведе результат. У другому виявить нестачу значень. У третьому кількість елементів буде правильною, але перетворення на число завершиться `ValueError`, який програма перехопить.
Саме так має працювати надійна обробка введення: спочатку перевірка структури, потім перетворення типів і лише після цього використання даних. Не покладайтеся на те, що користувач завжди введе саме те, чого очікує програма.
Ви щойно перевірили шість базових сценаріїв: від простого `split` до регулярних виразів і контрольованої обробки помилок. Це невеликий, але справжній початок роботи з текстом у Python.
Далі на вас чекає повний практичний маршрут: від простого розбиття рядків до створення надійних інструментів, які впевнено працюють із реальним текстом.
Це безкоштовний уривок. Повна книга — на сторінці книги.
